CADERNO DE FASE 5-S MACHINE LEARNING SPECIALTY
Estrutura oficial do exame MLS-C01: domínios com peso, declarações de tarefa e os itens de conhecimento e habilidade do guia da AWS, em português. Marque cada item conforme domina, escreva anotações, anexe materiais e crie subtópicos seus em qualquer nível.
Guia oficial do exame (em inglês) · Baixar pôster de resumo (PNG) · Voltar ao mapa
DOMÍNIOS
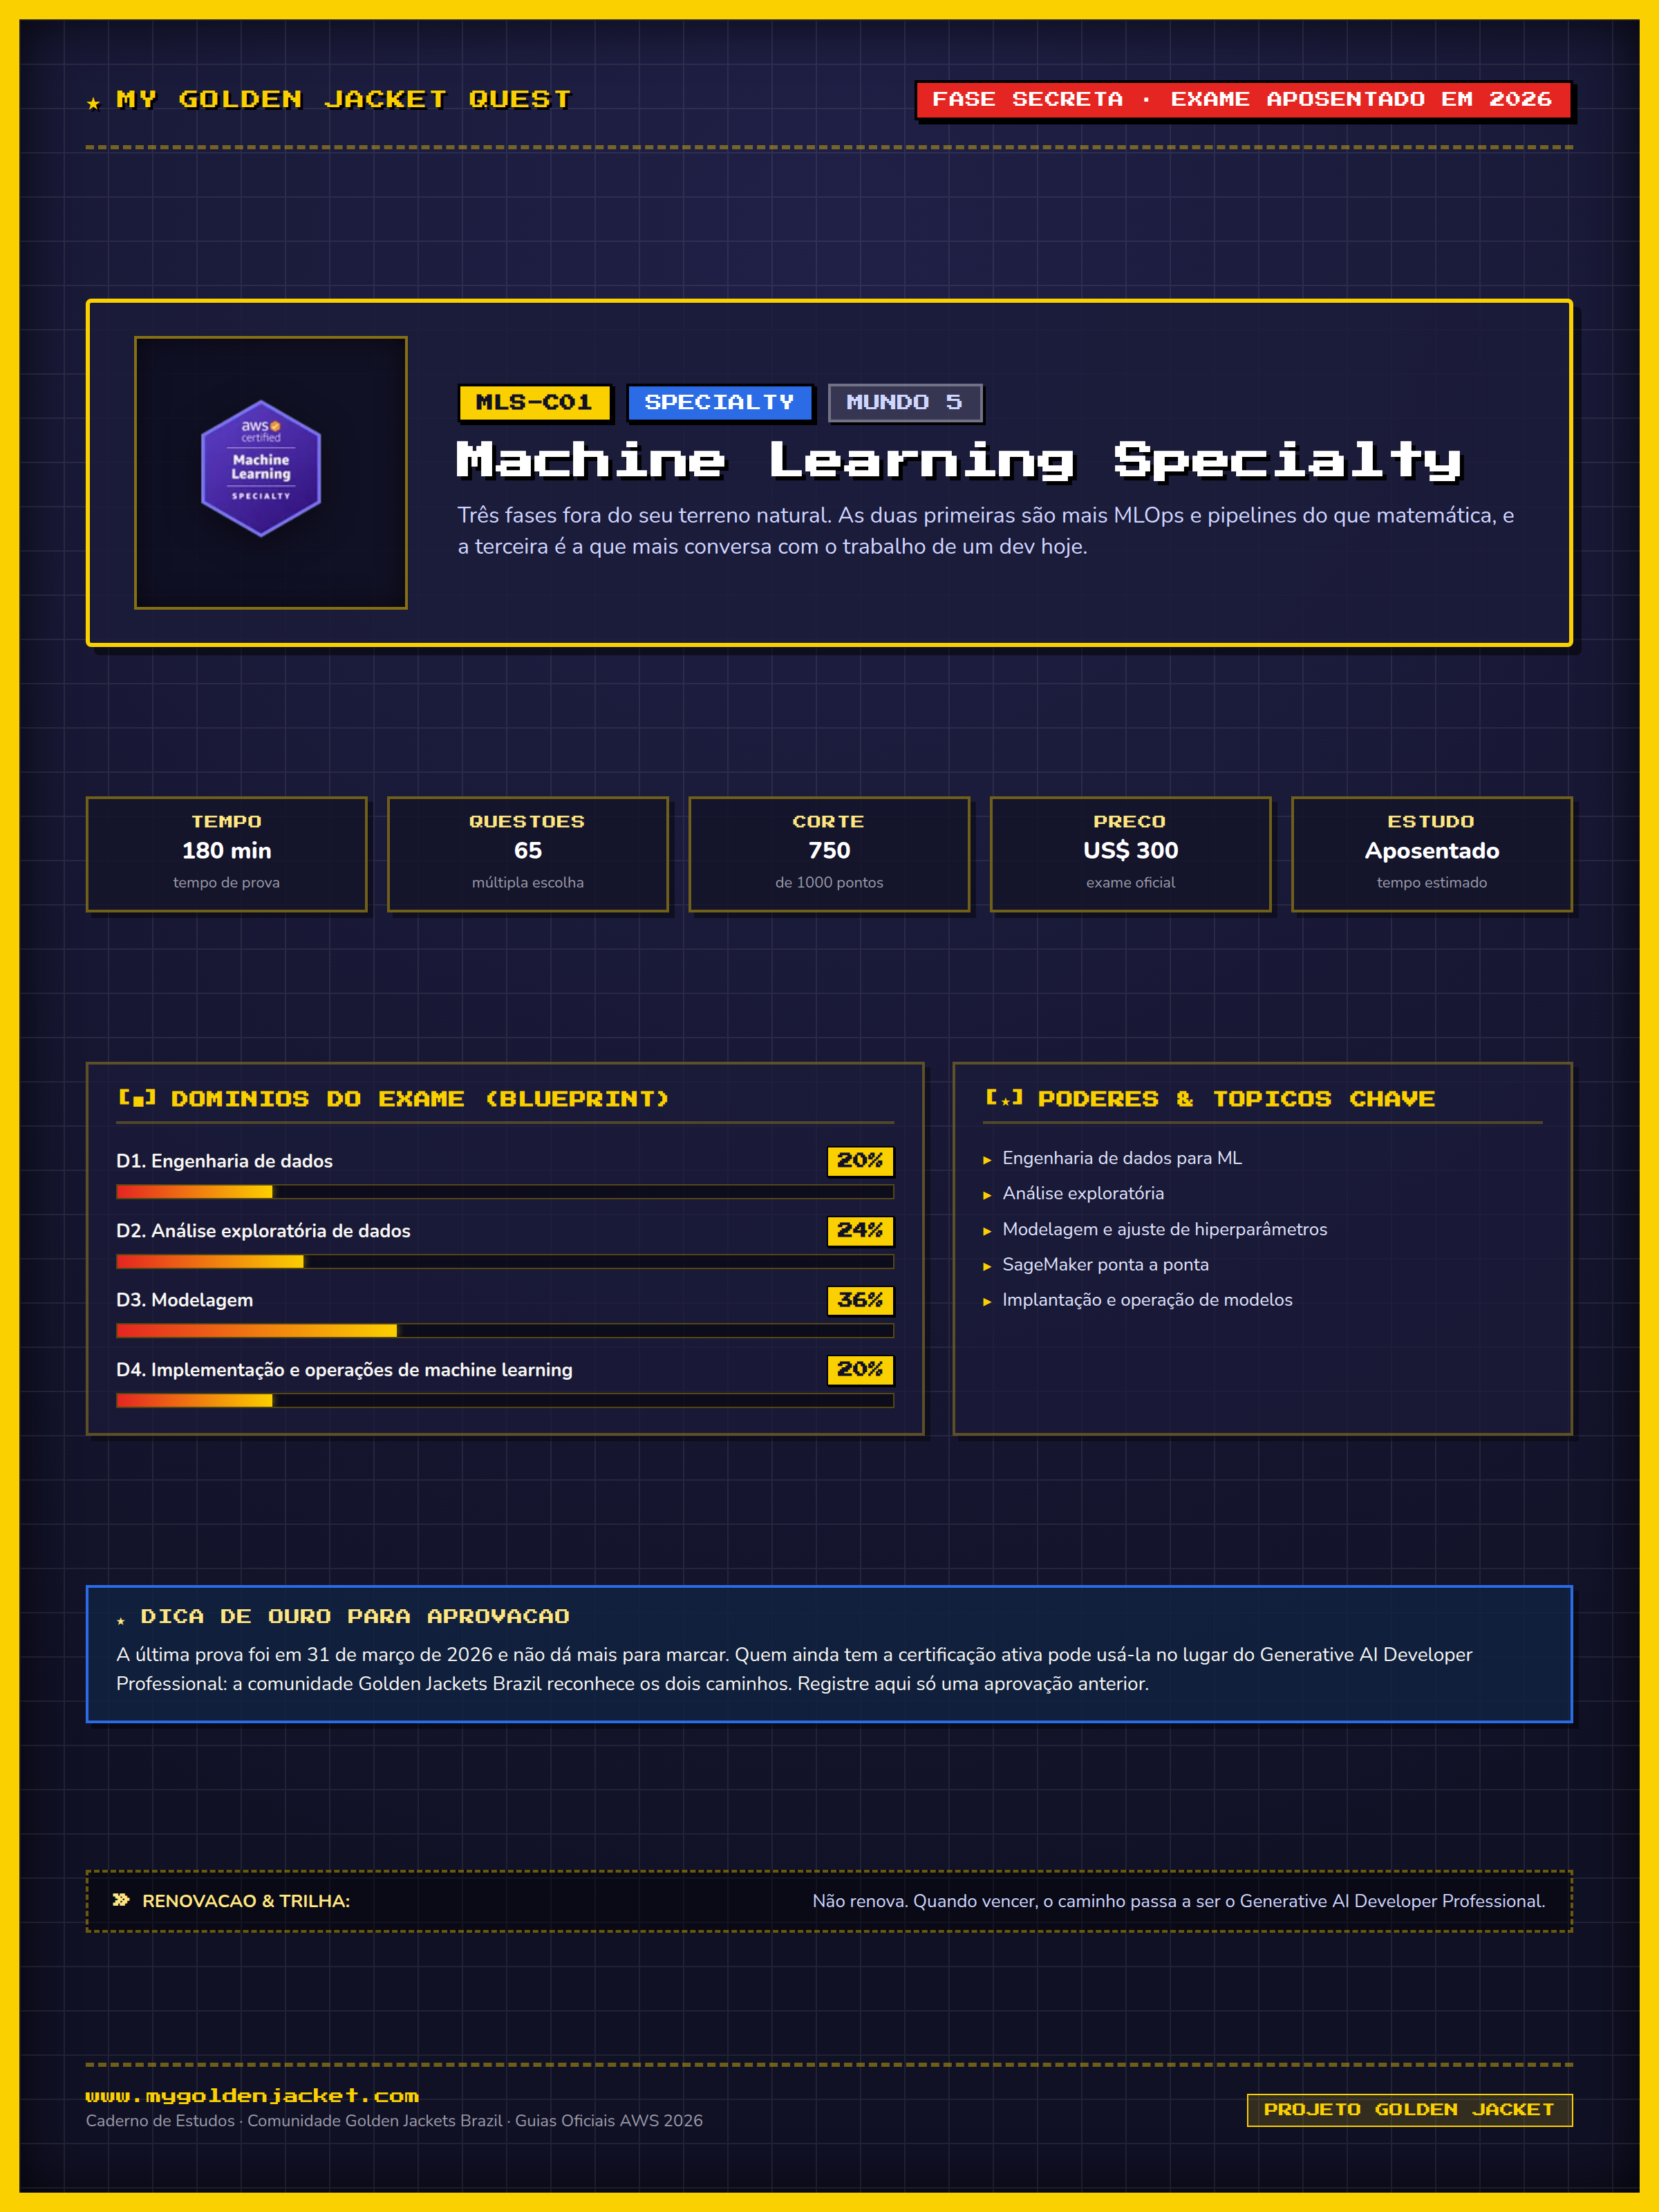
- 1 Engenharia de dados 20%
- 2 Análise exploratória de dados 24%
- 3 Modelagem 36%
- 4 Implementação e operações de machine learning 20%
Sobre o Machine Learning Specialty (MLS-C01), exame aposentado
O Machine Learning Specialty foi aposentado pela AWS: a última data de prova foi 31 de março de 2026 e não dá mais para marcar. Era um exame de 65 questões em 180 minutos, nota mínima 750, com a modelagem valendo 36%: escolha de algoritmo, ajuste de hiperparâmetros, métricas e SageMaker ponta a ponta, mais engenharia de dados, análise exploratória e operação de modelos.
Quem ainda tem a certificação ativa pode usá-la no lugar do Generative AI Developer Professional (AIP-C01) no caminho da jaqueta: a comunidade Golden Jackets Brazil reconhece os dois. Quando ela vencer, não há renovação, e o caminho passa a ser o Generative AI Developer Professional.
Este caderno fica no mapa como fase secreta, para registrar uma aprovação anterior e guardar as anotações. Se você está começando agora, vá direto ao Generative AI Developer Professional (AIP-C01) e, para a base de MLOps, ao ML Engineer Associate (MLA-C01 e MLA-C02); os tópicos daqui ainda servem como revisão de fundamentos de modelagem.
Domínio 1: Engenharia de dados 20% do exame
1.1 Criar repositórios de dados para ML.
Objetivos
- Identificar fontes de dados (por exemplo, conteúdo e localização, fontes primárias como dados de usuários).
- Determinar meios de armazenamento (por exemplo, bancos de dados, Amazon S3, Amazon Elastic File System [Amazon EFS], Amazon Elastic Block Store [Amazon EBS]).
1.2 Identificar e implementar uma solução de ingestão de dados.
Objetivos
- Identificar estilos e tipos de trabalhos de dados (por exemplo, carga em lote, streaming).
- Orquestrar pipelines de ingestão de dados (workloads de ML baseadas em lote e workloads de ML baseadas em streaming).
- Amazon Kinesis
- Amazon Data Firehose
- Amazon EMR
- AWS Glue
- Amazon Managed Service for Apache Flink
- Agendar trabalhos.
1.3 Identificar e implementar uma solução de transformação de dados.
Objetivos
- Transformar dados em trânsito (ETL, AWS Glue, Amazon EMR, AWS Batch).
- Lidar com dados específicos de ML usando MapReduce (por exemplo, Apache Hadoop, Apache Spark, Apache Hive).
Domínio 2: Análise exploratória de dados 24% do exame
2.1 Higienizar e preparar dados para modelagem.
Objetivos
- Identificar e tratar dados ausentes, dados corrompidos e stop words.
- Formatar, normalizar, aumentar e escalar dados.
- Determinar se há dados rotulados suficientes.
- Identificar estratégias de mitigação.
- Usar ferramentas de rotulagem de dados (por exemplo, Amazon Mechanical Turk).
2.2 Realizar engenharia de atributos (feature engineering).
Objetivos
- Identificar e extrair atributos de conjuntos de dados, inclusive de fontes como texto, fala, imagens e conjuntos de dados públicos.
- Analisar e avaliar conceitos de engenharia de atributos (por exemplo, binning, tokenização, outliers, atributos sintéticos, one-hot encoding, redução da dimensionalidade dos dados).
2.3 Analisar e visualizar dados para ML.
Objetivos
- Criar gráficos (por exemplo, gráficos de dispersão, séries temporais, histogramas, box plots).
- Interpretar estatísticas descritivas (por exemplo, correlação, estatísticas de resumo, valor-p).
- Realizar análise de clusters (por exemplo, hierárquica, diagnóstico, gráfico de cotovelo, tamanho do cluster).
Domínio 3: Modelagem 36% do exame
3.1 Enquadrar problemas de negócios como problemas de ML.
Objetivos
- Determinar quando usar e quando não usar ML.
- Conhecer a diferença entre aprendizado supervisionado e não supervisionado.
- Selecionar entre classificação, regressão, previsão, clustering, recomendação e modelos de base.
3.2 Selecionar o(s) modelo(s) adequado(s) para um determinado problema de ML.
Objetivos
- XGBoost, regressão logística, k-means, regressão linear, árvores de decisão, florestas aleatórias, RNN, CNN, ensemble, transfer learning e grandes modelos de linguagem (LLMs)
- Expressar a intuição por trás dos modelos.
3.3 Treinar modelos de ML.
Objetivos
- Dividir os dados entre treinamento e validação (por exemplo, validação cruzada).
- Entender técnicas de otimização para treinamento de ML (por exemplo, gradiente descendente, funções de perda, convergência).
- Escolher recursos de computação adequados (por exemplo, GPU ou CPU, distribuído ou não distribuído).
- Escolher plataformas de computação adequadas (Spark ou não Spark).
- Atualizar e retreinar modelos.
- Em lote ou em tempo real/online
3.4 Realizar otimização de hiperparâmetros.
Objetivos
- Aplicar regularização.
- Dropout
- L1/L2
- Realizar validação cruzada.
- Inicializar modelos.
- Entender a arquitetura de redes neurais (camadas e nós), a taxa de aprendizado e as funções de ativação.
- Entender modelos baseados em árvores (número de árvores, número de níveis).
- Entender modelos lineares (taxa de aprendizado).
3.5 Avaliar modelos de ML.
Objetivos
- Evitar overfitting ou underfitting.
- Detectar e tratar viés e variância.
- Avaliar métricas (por exemplo, área sob a curva [AUC] e característica de operação do receptor [ROC], acurácia, precisão, recall, raiz do erro quadrático médio [RMSE], F1 score).
- Interpretar matrizes de confusão.
- Realizar avaliação de modelos offline e online (testes A/B).
- Comparar modelos usando métricas (por exemplo, tempo para treinar um modelo, qualidade do modelo, custos de engenharia).
- Realizar validação cruzada.
Domínio 4: Implementação e operações de machine learning 20% do exame
4.1 Criar soluções de ML visando performance, disponibilidade, escalabilidade, resiliência e tolerância a falhas.
Objetivos
- Registrar em log e monitorar ambientes da AWS.
- AWS CloudTrail e Amazon CloudWatch
- Criar soluções de monitoramento de erros.
- Implantar em várias Regiões da AWS e várias Zonas de Disponibilidade.
- Criar AMIs e imagens douradas (golden images).
- Criar contêineres Docker.
- Implantar grupos do Auto Scaling.
- Dimensionar corretamente os recursos (por exemplo, instâncias, IOPS provisionadas, volumes).
- Realizar balanceamento de carga.
- Seguir as práticas recomendadas da AWS.
4.2 Recomendar e implementar os serviços e recursos de ML adequados para um determinado problema.
Objetivos
- ML na AWS (serviços de aplicação), por exemplo:
- Amazon Polly
- Amazon Lex
- Amazon Transcribe
- Amazon Q
- Entender as cotas de serviço da AWS.
- Determinar quando criar modelos personalizados e quando usar os algoritmos integrados do Amazon SageMaker.
- Entender a infraestrutura da AWS (por exemplo, tipos de instância) e considerações de custo.
- Usar instâncias spot para treinar modelos de aprendizado profundo com o AWS Batch.
4.3 Aplicar práticas básicas de segurança da AWS a soluções de ML.
Objetivos
- AWS Identity and Access Management (IAM)
- Políticas de bucket do S3
- Grupos de segurança
- VPCs
- Criptografia e anonimização
4.4 Implantar e operacionalizar soluções de ML.
Objetivos
- Expor endpoints e interagir com eles.
- Entender modelos de ML.
- Realizar testes A/B.
- Retreinar pipelines.
- Depurar e solucionar problemas de modelos de ML.
- Detectar e mitigar quedas de performance.
- Monitorar a performance do modelo.
A AWS publicou este guia só em inglês; os tópicos foram traduzidos por nós seguindo a terminologia dos guias oficiais em português. Entre ou crie uma conta para registrar o que já domina, escrever anotações e anexar materiais.