CADERNO DE FASE 5-2 ML ENGINEER ASSOCIATE
Estrutura oficial do exame MLA-C02: domínios com peso, declarações de tarefa e os itens de conhecimento e habilidade do guia da AWS, em português. Marque cada item conforme domina, escreva anotações, anexe materiais e crie subtópicos seus em qualquer nível.
- MLA-C01: até 13/01/2027
- MLA-C02: beta até 13/01/2027
Guia oficial do exame (em inglês) · Baixar pôster de resumo do MLA-C02 (PNG) · Baixar pôster de resumo do MLA-C01 (PNG) · Voltar ao mapa
DOMÍNIOS
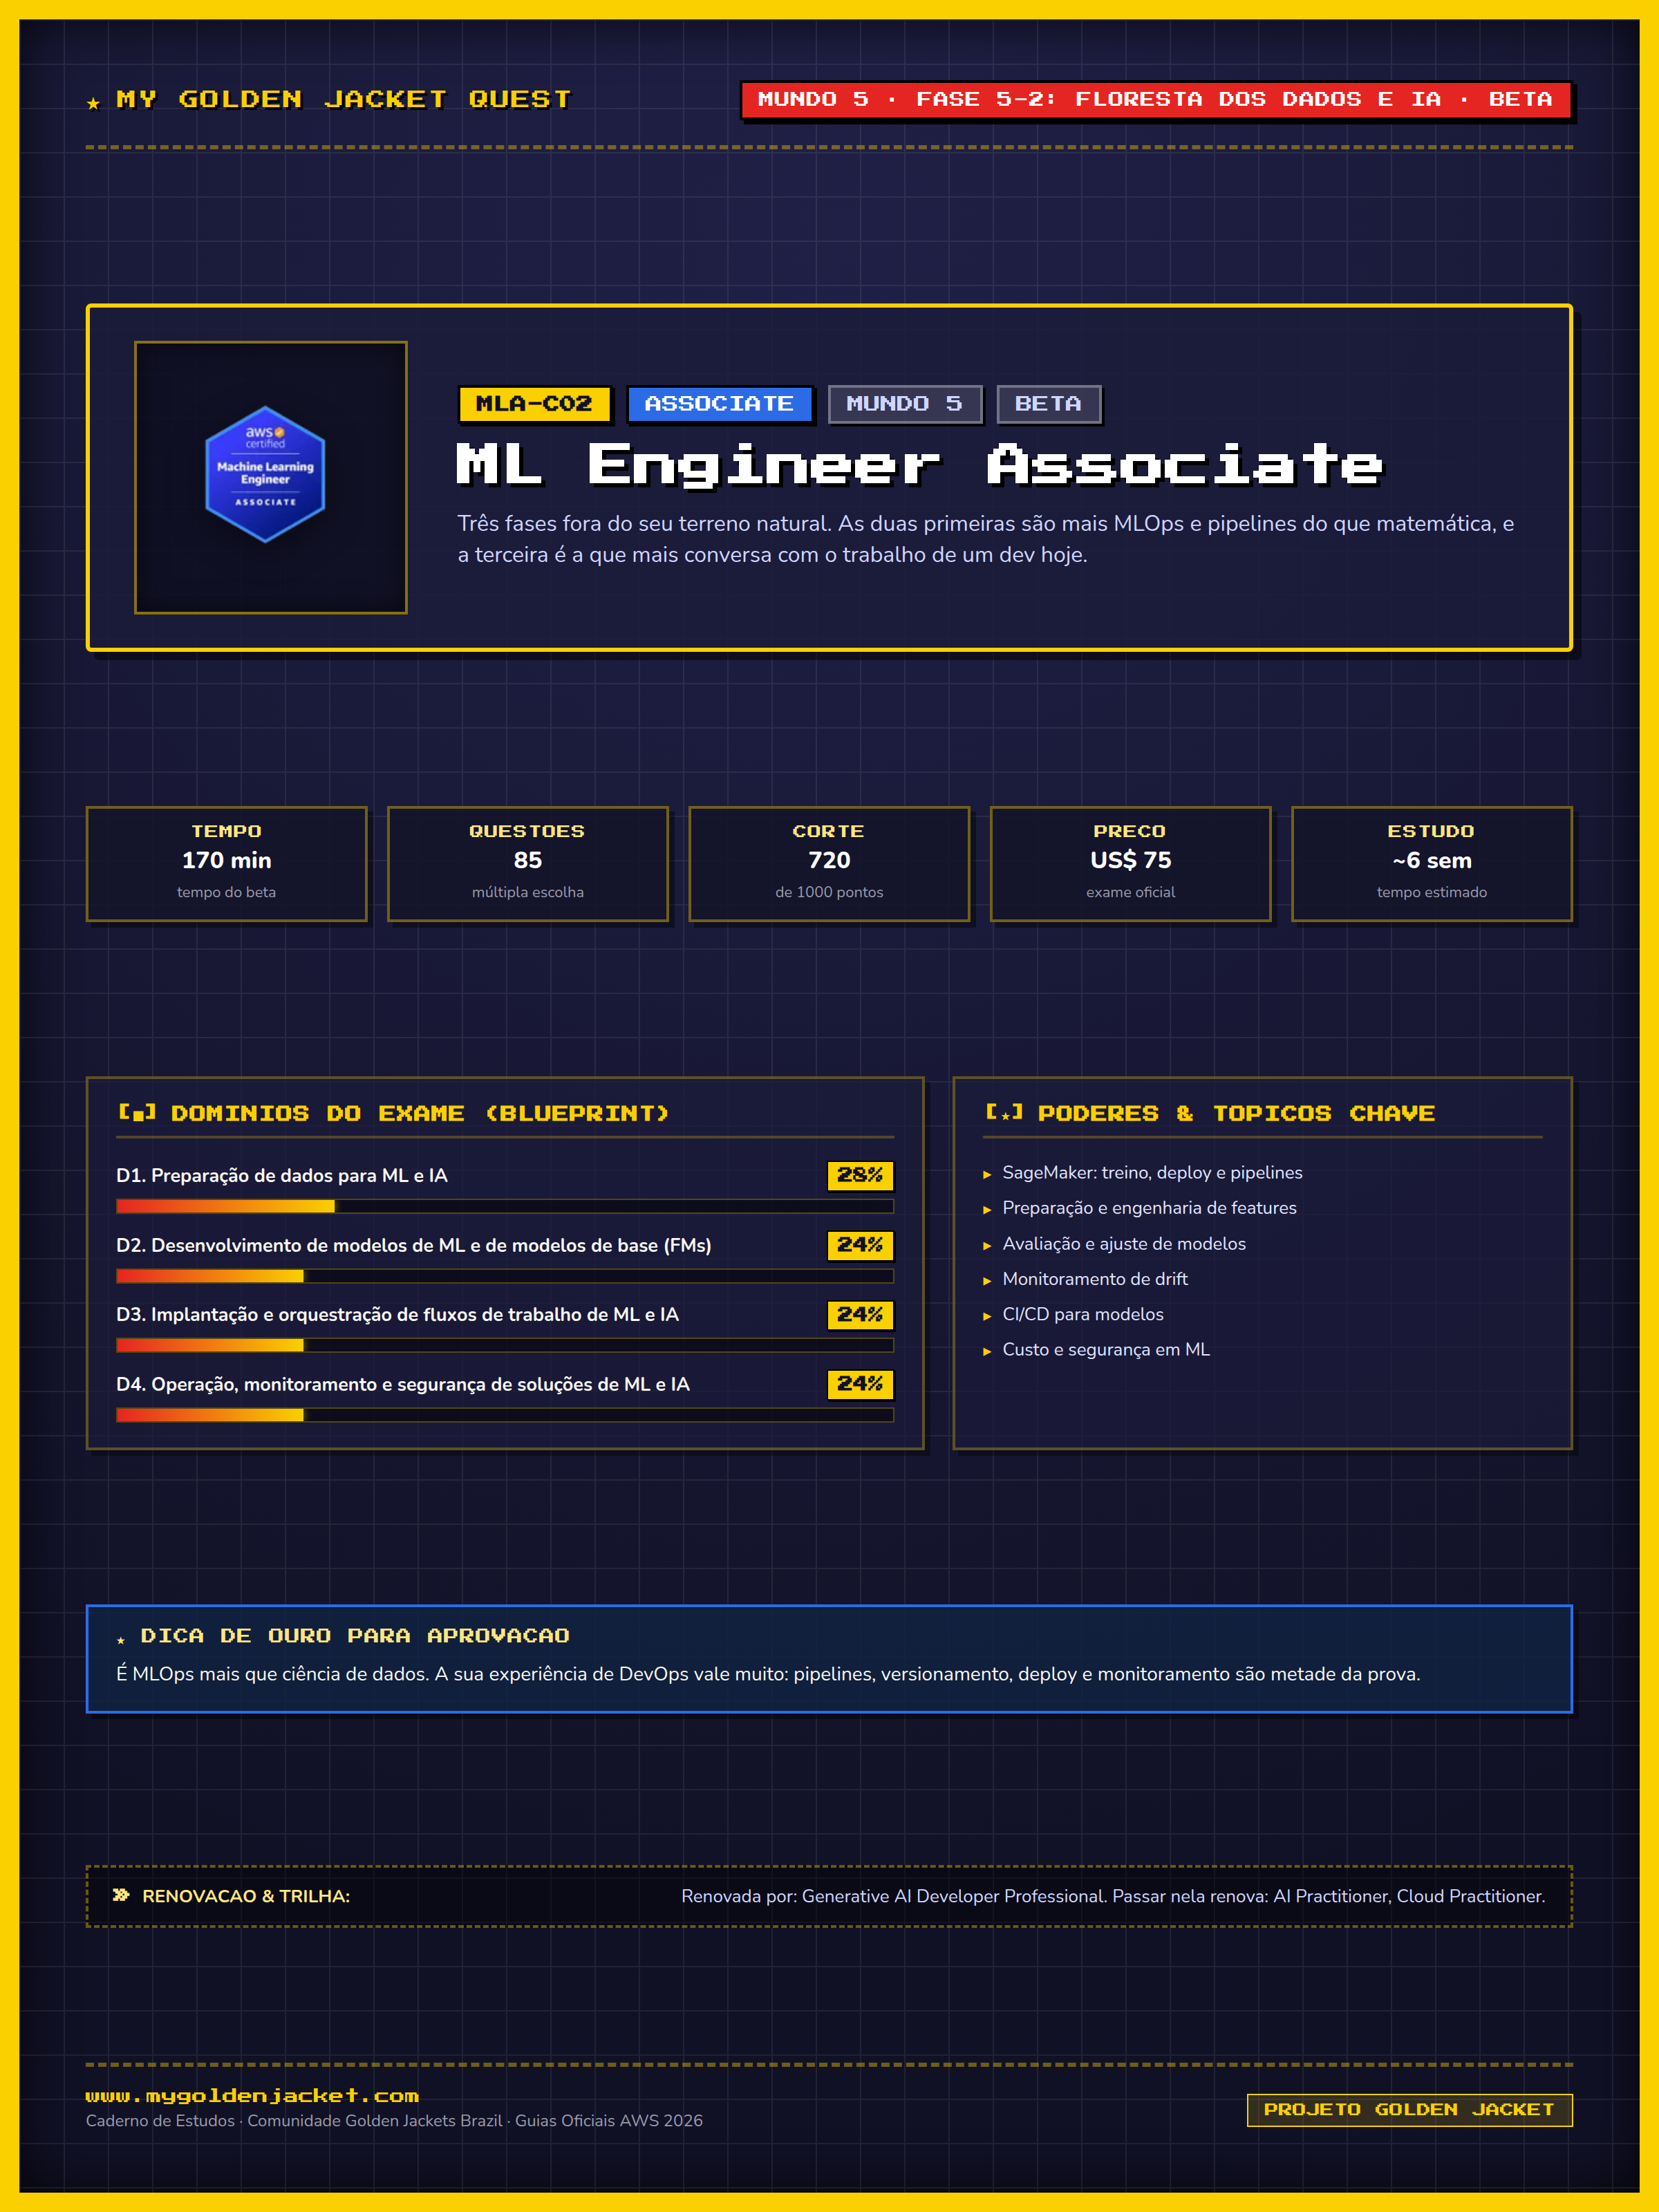
- 1 Preparação de dados para ML e IA 28%
- 2 Desenvolvimento de modelos de ML e de modelos de base (FMs) 24%
- 3 Implantação e orquestração de fluxos de trabalho de ML e IA 24%
- 4 Operação, monitoramento e segurança de soluções de ML e IA 24%
Como estudar para o ML Engineer Associate (MLA-C01 e MLA-C02)
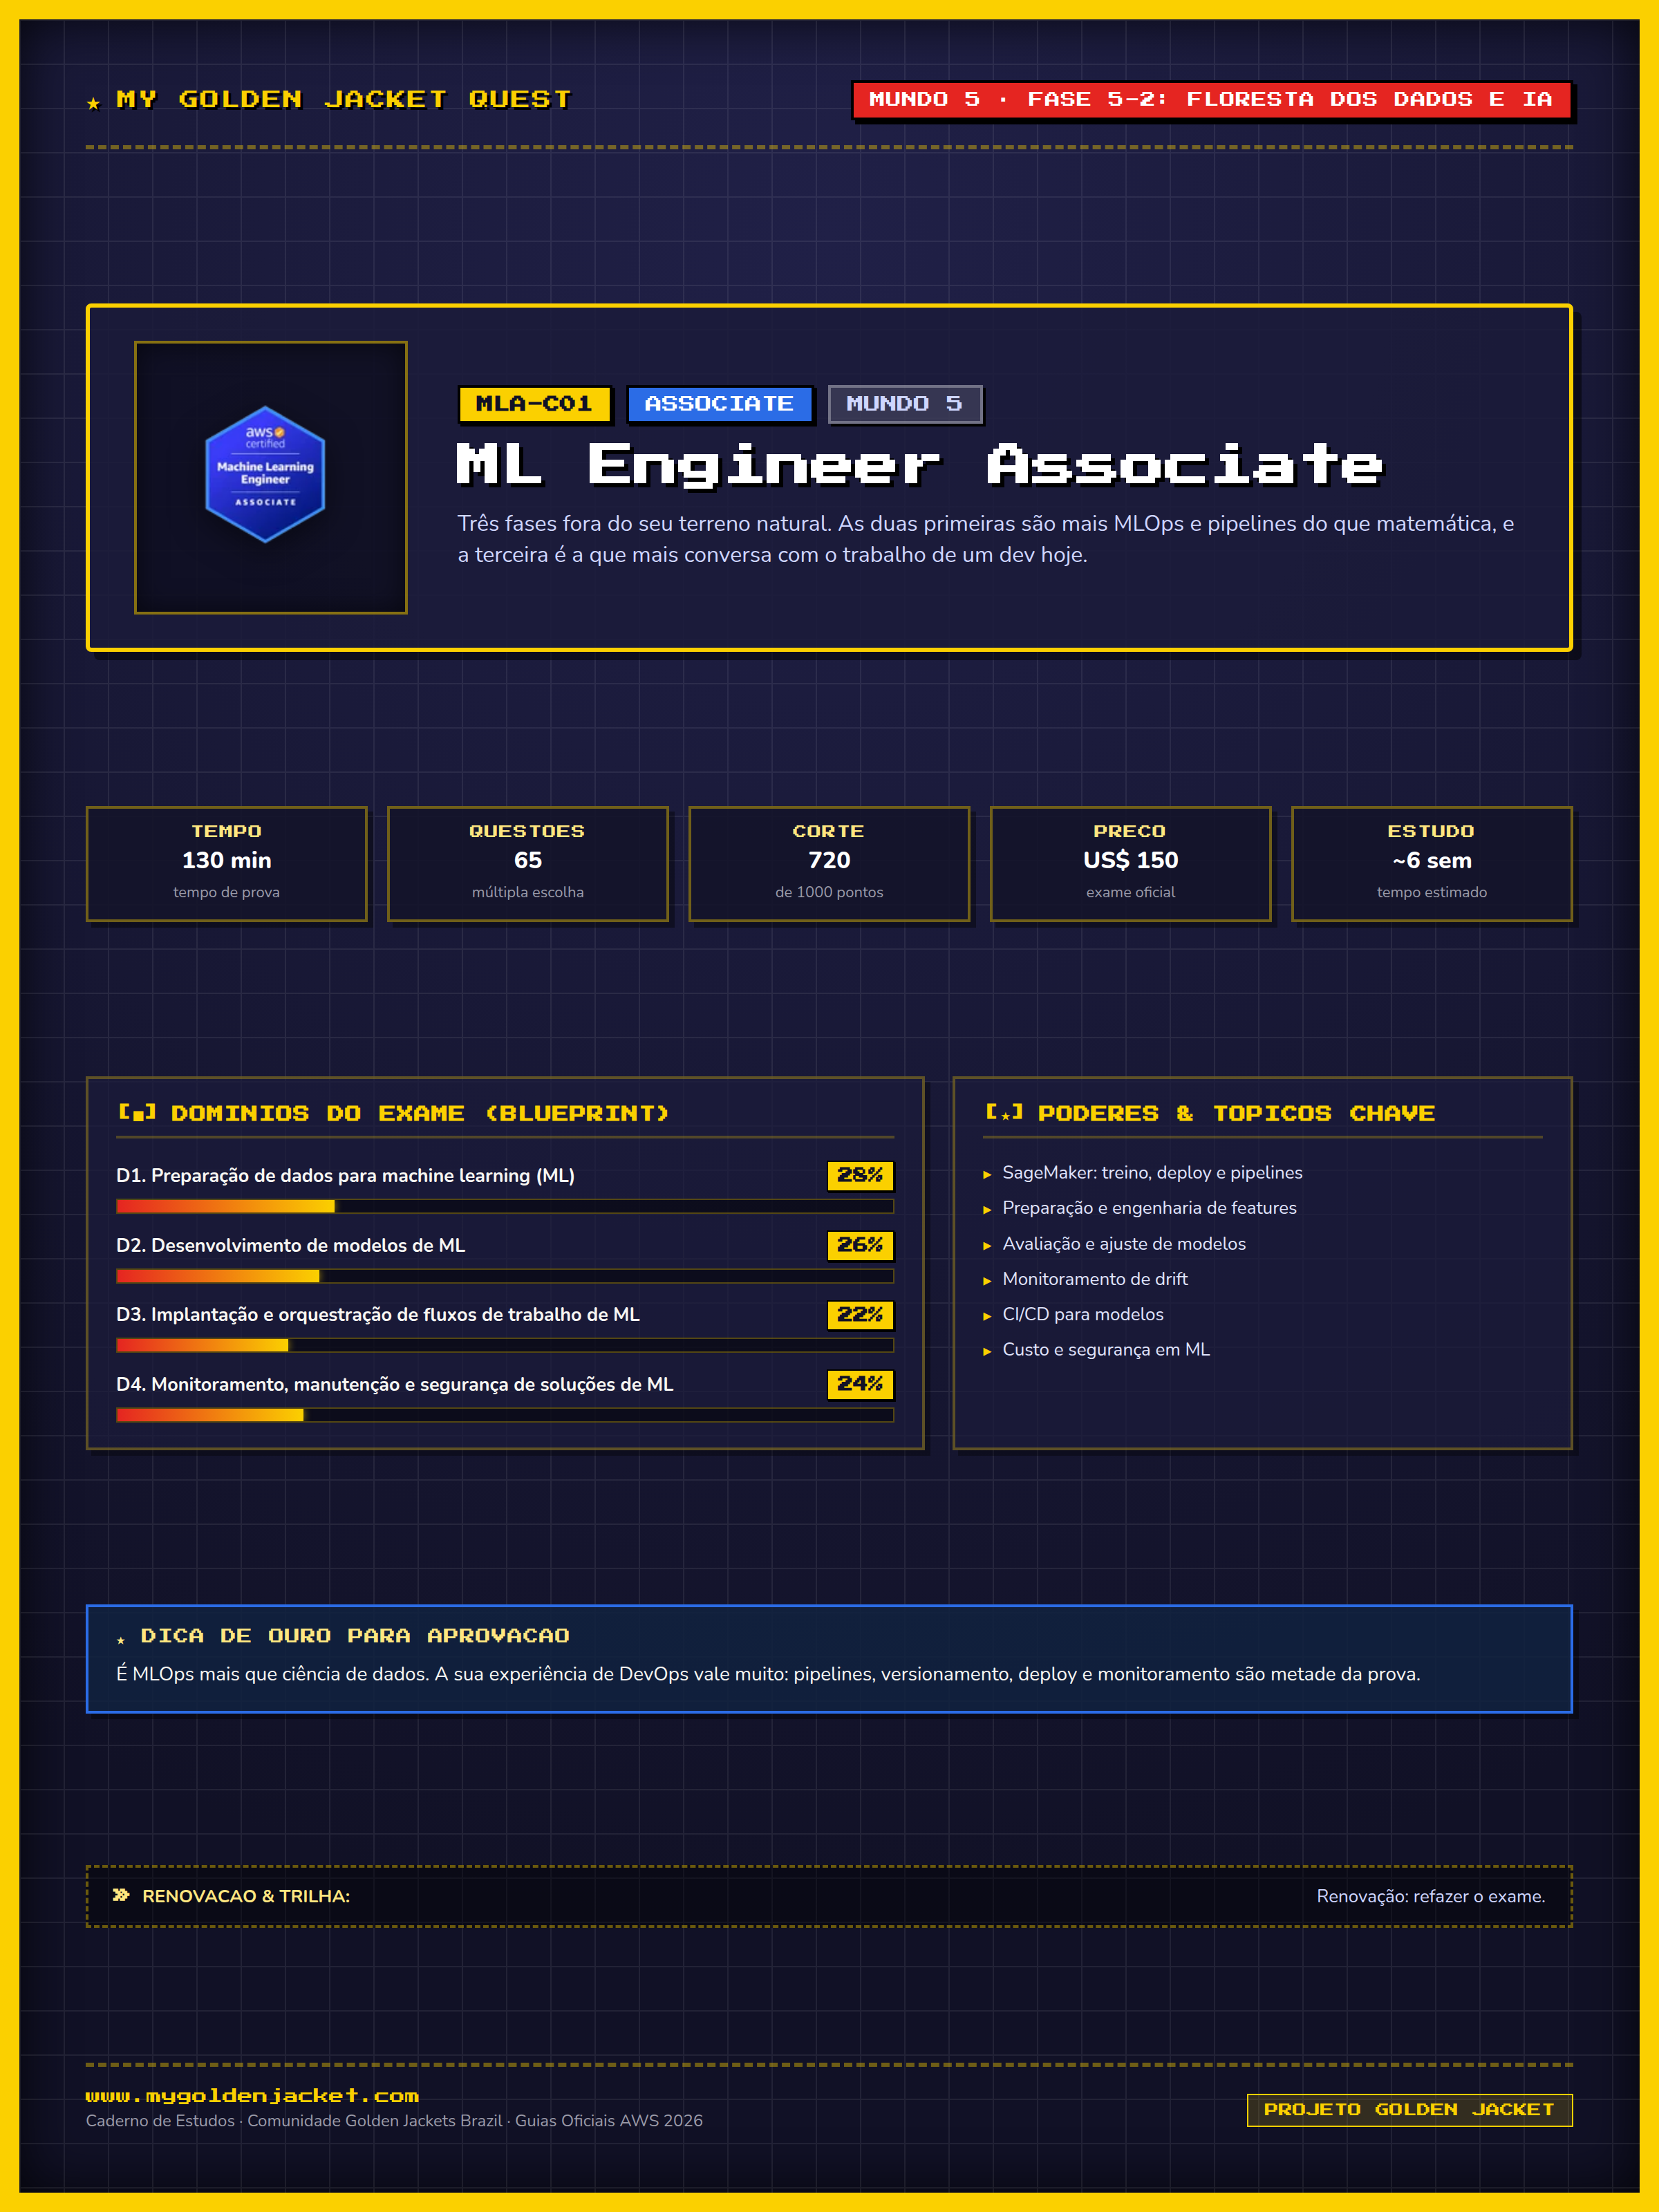
O ML Engineer Associate é MLOps mais do que ciência de dados. A versão MLA-C02 está em beta desde 29 de setembro de 2026: 85 questões em 170 minutos, US$ 75, só em inglês. O resultado sai depois do fim do beta, previsto para 14/01/2027, e não deve chegar antes do re:Invent 2026. O MLA-C01 (65 questões em 130 minutos, nota mínima 720) segue aplicado em japonês, coreano e chinês até 13/01/2027.
O conteúdo deste caderno é o do MLA-C01, a versão regular: preparação de dados (28%) e desenvolvimento de modelos (26%) cobram SageMaker Data Wrangler, Feature Store, algoritmos embutidos, ajuste de hiperparâmetros e métricas de avaliação; implantação e orquestração (22%) e monitoramento, manutenção e segurança (24%) cobram endpoints, SageMaker Pipelines, CI/CD para modelos, Model Monitor e drift, além de custo e IAM para ML. Os tópicos foram traduzidos do guia em inglês.
Segunda fase do Mundo 5. Faça depois do Data Engineer Associate (DEA-C01): preparação e armazenamento de dados são o mesmo assunto visto de outro ângulo. A experiência de DevOps vale muito aqui, porque pipelines, versionamento, deploy e monitoramento são quase metade da prova. Ela é renovada pelo Generative AI Developer Professional (AIP-C01): passar nele a renova por mais três anos. Seis semanas bastam: treine um modelo com um algoritmo embutido do SageMaker, publique num endpoint, ligue o Model Monitor e force um drift para ver o alarme. Nas anotações, guarde qual métrica serve a cada tipo de problema e qual tipo de endpoint serve a cada padrão de tráfego.
Domínio 1: Preparação de dados para ML e IA 28% do exame
1.1 Coletar e armazenar dados.
- Extrair dados de fontes de dados (por exemplo, Amazon S3, Amazon EBS, Amazon EFS, Amazon RDS, Amazon DynamoDB, Amazon OpenSearch Service).
- Tomar decisões de armazenamento e configurar serviços de armazenamento com base em custo, performance, estrutura dos dados e conformidade dos dados.
- Solucionar problemas e depurar questões de ingestão e armazenamento de dados que envolvam capacidade e escalabilidade.
- Usar fontes de dados em streaming da AWS para ingerir dados (por exemplo, usando Amazon Kinesis, Apache Flink, Apache Kafka).
- Ingerir e gravar dados usando formatos adequados (por exemplo, Apache Parquet, JSON, CSV, ORC) com base nos padrões de acesso aos dados.
- Mesclar dados de várias fontes (por exemplo, usando técnicas de programação, AWS Glue, Apache Spark).
- Configurar bancos de dados vetoriais escaláveis para aplicações de IA (por exemplo, OpenSearch Service, Amazon RDS com pgvector, Amazon S3) com base em especificações.
- Ingerir e armazenar diversos tipos de dados (por exemplo, texto, imagens, áudio) para aplicações de IA e ML.
- Ingerir dados no SageMaker Feature Store.
1.2 Realizar transformação de dados, engenharia de atributos (feature engineering) e pré-processamento.
- Transformar dados usando ferramentas da AWS (por exemplo, AWS Glue, AWS Glue DataBrew, Spark em execução no Amazon EMR, SageMaker Data Wrangler).
- Criar e gerenciar atributos usando ferramentas da AWS (por exemplo, SageMaker Feature Store).
- Transformar dados em streaming (por exemplo, usando AWS Lambda, Spark).
- Realizar engenharia de atributos (por exemplo, escalonamento, padronização, divisão de atributos, binning, transformação logarítmica, normalização).
- Configurar e usar modelos de embeddings para transformar dados de texto e de imagem em representações numéricas.
- Aplicar técnicas avançadas de pré-processamento de texto (por exemplo, tokenização, aumento de dados específico do domínio).
- Preparar documentos para aplicações de geração aumentada de recuperação (RAG) (por exemplo, estratégias de fragmentação [chunking], extração de metadados).
- Mascarar, ocultar e anonimizar dados.
- Preparar dados para ajuste fino de FMs, pré-treinamento contínuo e destilação de modelos.
1.3 Validar a qualidade dos dados e gerenciar o viés.
- Validar a qualidade dos dados (por exemplo, usando o DataBrew e o AWS Glue Data Quality).
- Rotular e anotar dados.
- Identificar e mitigar fontes de viés nos dados usando ferramentas e técnicas da AWS (por exemplo, divisão, embaralhamento e aumento do conjunto de dados).
- Otimizar distribuições de dados multimodais aplicando métricas de viés a ativos numéricos, de texto e de imagem.
- Resolver o desequilíbrio de classes em conjuntos de dados numéricos, de texto e de imagem.
- Validar a integridade dos dados de treinamento de IA (por exemplo, validação de pares de prompt e resposta, triagem de segurança de conteúdo).
- Limpar dados (por exemplo, detecção de outliers, imputação de dados ausentes, desduplicação).
Domínio 2: Desenvolvimento de modelos de ML e de modelos de base (FMs) 24% do exame
2.1 Escolher abordagens de modelagem adequadas para soluções de ML e IA.
- Avaliar e selecionar FMs adequados do Amazon Bedrock com base nos requisitos da tarefa e em critérios de performance.
- Identificar estratégias de ajuste fino de FMs pré-treinados para atender às necessidades de negócios.
- Comparar e selecionar modelos de ML, modelos de IA generativa, algoritmos e modelos de solução adequados para atender às necessidades de negócios (por exemplo, interpretabilidade, performance específica do domínio, latência).
- Avaliar compensações entre soluções personalizadas, serviços gerenciados, modelos pré-treinados e FMs para atender às necessidades de negócios.
- Selecionar padrões de arquitetura de geração aumentada de recuperação (RAG) com base nos requisitos do caso de uso.
- Avaliar compensações entre performance do modelo de ML, tempo de treinamento e custo.
- Avaliar compensações entre performance do modelo de IA, latência e custo.
- Aplicar serviços de IA da AWS para resolver problemas de negócios específicos (por exemplo, Amazon Textract, Amazon Rekognition, Amazon Comprehend, Amazon Transcribe).
2.2 Treinar, fazer o ajuste fino e personalizar modelos para soluções de ML e IA.
- Aplicar os algoritmos integrados do Amazon SageMaker AI e bibliotecas comuns de ML.
- Configurar o modo de script do SageMaker AI com os frameworks compatíveis, visando simplicidade e performance.
- Implementar a otimização de hiperparâmetros (por exemplo, ajuste automático de modelos [AMT] do SageMaker AI).
- Implementar técnicas para reduzir o tempo de treinamento (por exemplo, parada antecipada, treinamento distribuído).
- Evitar overfitting, underfitting e esquecimento catastrófico do modelo.
- Combinar vários modelos de ML para melhorar a performance ou reduzir o custo.
- Ajustar hiperparâmetros fundamentais (por exemplo, época, etapas, tamanho do lote).
- Aplicar técnicas de personalização para soluções de IA (por exemplo, engenharia de prompts específica da tarefa, ajuste fino).
- Otimizar componentes de recuperação e modelos de embeddings.
2.3 Analisar e avaliar a performance de sistemas de ML e IA.
- Realizar experimentos reproduzíveis (por exemplo, usando MLflow no SageMaker AI, avaliações do Amazon Bedrock, Amazon Bedrock Prompt Management).
- Criar linhas de base de performance do modelo e implementar a detecção de desvio (drift).
- Comparar a performance de variantes sombra (shadow) com a de variantes de produção.
- Explicar as saídas do modelo.
- Depurar problemas de convergência do modelo.
- Aplicar técnicas abrangentes de avaliação de modelos de ML tradicional e de IA generativa.
- Implementar frameworks integrados de avaliação humana (por exemplo, fluxos de trabalho com intervenção humana [human-in-the-loop], avaliação da qualidade da geração de texto).
- Aplicar métricas de avaliação de processamento de linguagem natural (PLN) (por exemplo, Bilingual Evaluation Understudy [BLEU], Recall-Oriented Understudy for Gisting Evaluation [ROUGE], BERTScore, similaridade semântica).
- Realizar a avaliação de IA (por exemplo, avaliação das saídas do modelo, validação da qualidade do conteúdo, detecção de viés, frameworks de LLM como juiz).
- Configurar o monitoramento de sistemas de RAG, incluindo a avaliação da precisão da recuperação.
Domínio 3: Implantação e orquestração de fluxos de trabalho de ML e IA 24% do exame
3.1 Gerenciar a infraestrutura de implantação para os tipos de modelo de ML e IA.
- Selecionar ambientes de computação e destinos de implantação adequados.
- Selecionar orquestradores de implantação e estratégias de implantação de vários modelos ou de vários contêineres.
- Selecionar estratégias de inferência de modelos (por exemplo, processamento em tempo real e em lote).
- Avaliar e selecionar opções adequadas de implantação de modelos de base (FMs).
- Implantar em ambientes da AWS modelos criados fora da AWS (por exemplo, Amazon SageMaker AI, Amazon Bedrock Custom Model Import).
- Implantar e configurar agentes para tarefas específicas, integração com outros serviços e ferramentas, e protocolos de comunicação entre agentes.
- Configurar a implantação de FMs, a hospedagem de modelos e a alocação de recursos.
- Aplicar configurações de sistemas de geração aumentada de recuperação (RAG) (por exemplo, estratégias de recuperação, reclassificação [reranking]).
3.2 Provisionar e configurar recursos para workloads de ML e IA com base na arquitetura e nos requisitos existentes.
- Otimizar o provisionamento entre recursos sob demanda e provisionados, visando performance e eficiência de custos.
- Automatizar o provisionamento de recursos de computação com comunicação integrada entre pilhas e serviços de orquestração.
- Criar e manter contêineres para workloads de ML e IA.
- Configurar endpoints do SageMaker AI em ambientes de rede da VPC.
- Implantar e hospedar modelos de forma programática (por exemplo, usando o SDK do SageMaker AI para Python, a AWS CLI, o Boto3).
- Selecionar métricas específicas para implementações de auto scaling.
- Criar e gerenciar bases de conhecimento do Amazon Bedrock com configurações de banco de dados vetorial, indexação de documentos e otimização da recuperação.
- Implementar pipelines de recuperação para atender às necessidades de negócios.
- Implementar sistemas de gerenciamento de estado de agentes.
- Implementar a escalabilidade de recursos específica de IA para workloads de GPU.
- Implantar a infraestrutura de fluxos de trabalho agênticos.
3.3 Implementar orquestração automatizada e pipelines de integração contínua e entrega contínua (CI/CD) para MLOps e workloads de IA.
- Implementar estratégias de implantação automatizada e ações de rollback.
- Configurar e solucionar problemas do AWS CodeBuild, do AWS CodeCommit, do AWS CodeDeploy, do AWS CodePipeline e do AWS CodeConnections.
- Configurar trabalhos de treinamento e inferência.
- Configurar estratégias de testes automatizados em pipelines de CI/CD para workloads de ML tradicional e de IA.
- Criar e integrar mecanismos para retreinar modelos.
- Gerenciar versões de modelos para repetibilidade e auditorias (por exemplo, SageMaker Model Registry, MLflow no SageMaker AI).
- Gerenciar prompts (por exemplo, Amazon Bedrock Prompt Management).
- Implementar pipelines automatizados de implantação de agentes e o gerenciamento de versões de agentes.
- Implementar frameworks de teste de modelos de IA, incluindo testes de prompts.
- Configurar a automação da implantação de FMs com versionamento de modelos com ajuste fino.
- Configurar a orquestração de pipelines específica de IA para atualizações de sistemas de RAG e ciclos de atualização de bases de conhecimento.
Domínio 4: Operação, monitoramento e segurança de soluções de ML e IA 24% do exame
4.1 Monitorar a inferência e a performance de modelos de ML e IA.
- Monitorar a performance do modelo em produção usando a observabilidade de IA generativa do Amazon CloudWatch, o Amazon Bedrock Model Evaluation e pipelines de detecção de desvio (drift).
- Monitorar fluxos de trabalho para detectar anomalias ou erros no processamento de dados ou na inferência do modelo.
- Detectar mudanças na distribuição dos dados que possam afetar a performance do modelo.
- Monitorar a performance do modelo em produção usando testes A/B.
- Monitorar e automatizar o gerenciamento da performance e da coordenação de agentes (por exemplo, detecção de falhas de coordenação, streaming truncado, falhas de ferramentas).
- Configurar o monitoramento de performance específico de IA para modelos de base (FMs), como as avaliações do Amazon Bedrock.
4.2 Otimizar e gerenciar custos e performance da infraestrutura de ML e IA.
- Selecionar famílias de instâncias de inferência para otimizar performance e custo.
- Configurar e usar ferramentas para solucionar problemas e analisar recursos (por exemplo, Amazon CloudWatch, Amazon Bedrock AgentCore Observability, AWS X-Ray).
- Configurar painéis para monitorar métricas de performance.
- Otimizar a capacidade visando custo, performance e confiabilidade.
- Otimizar custos e definir cotas de custo usando as ferramentas de gerenciamento de custos adequadas.
- Otimizar os custos de infraestrutura selecionando opções de compra.
- Avaliar as implicações de custo do uso de FMs para inferência em produção.
- Monitorar os padrões de consumo de recursos de agentes.
- Gerenciar os custos de inferência de FMs otimizando o uso.
- Monitorar padrões de custo específicos de IA (por exemplo, otimização do uso de tokens, custos de computação de embeddings, otimização do armazenamento em bancos de dados vetoriais).
4.3 Proteger workloads de ML e IA e endpoints de modelos.
- Proteger pipelines de integração contínua e entrega contínua (CI/CD) verificando vulnerabilidades de código e de imagens (por exemplo, usando o Amazon CodeGuru, o Amazon Inspector).
- Configurar acesso com privilégio mínimo a artefatos de ML e IA.
- Configurar políticas e perfis do IAM para usuários e aplicações em sistemas de ML e IA.
- Configurar monitoramento, auditoria, conformidade e registro em log abrangentes para sistemas de ML e IA (por exemplo, AWS CloudTrail, AWS Config).
- Solucionar problemas e depurar questões de segurança em sistemas de ML e IA.
- Criar VPCs, sub-redes e grupos de segurança para isolar sistemas de ML e IA com segurança.
- Identificar e mitigar riscos e vulnerabilidades de segurança em sistemas de ML e IA.
- Selecionar o tipo de credencial adequado para acessar FMs (por exemplo, chaves de API do Amazon Bedrock, credenciais do IAM).
- Implementar proteções e a proteção de dados sigilosos para atender aos requisitos da aplicação e às políticas de IA responsável (por exemplo, usando o Amazon Bedrock Guardrails).
A AWS publicou este guia só em inglês; os tópicos foram traduzidos por nós seguindo a terminologia dos guias oficiais em português. Entre ou crie uma conta para registrar o que já domina, escrever anotações e anexar materiais.