CADERNO DE FASE 5-1 DATA ENGINEER ASSOCIATE
Estrutura oficial do exame DEA-C01: domínios com peso, declarações de tarefa e os itens de conhecimento e habilidade do guia da AWS, em português. Marque cada item conforme domina, escreva anotações, anexe materiais e crie subtópicos seus em qualquer nível.
Guia oficial do exame (em inglês) · Baixar pôster de resumo (PNG) · Voltar ao mapa
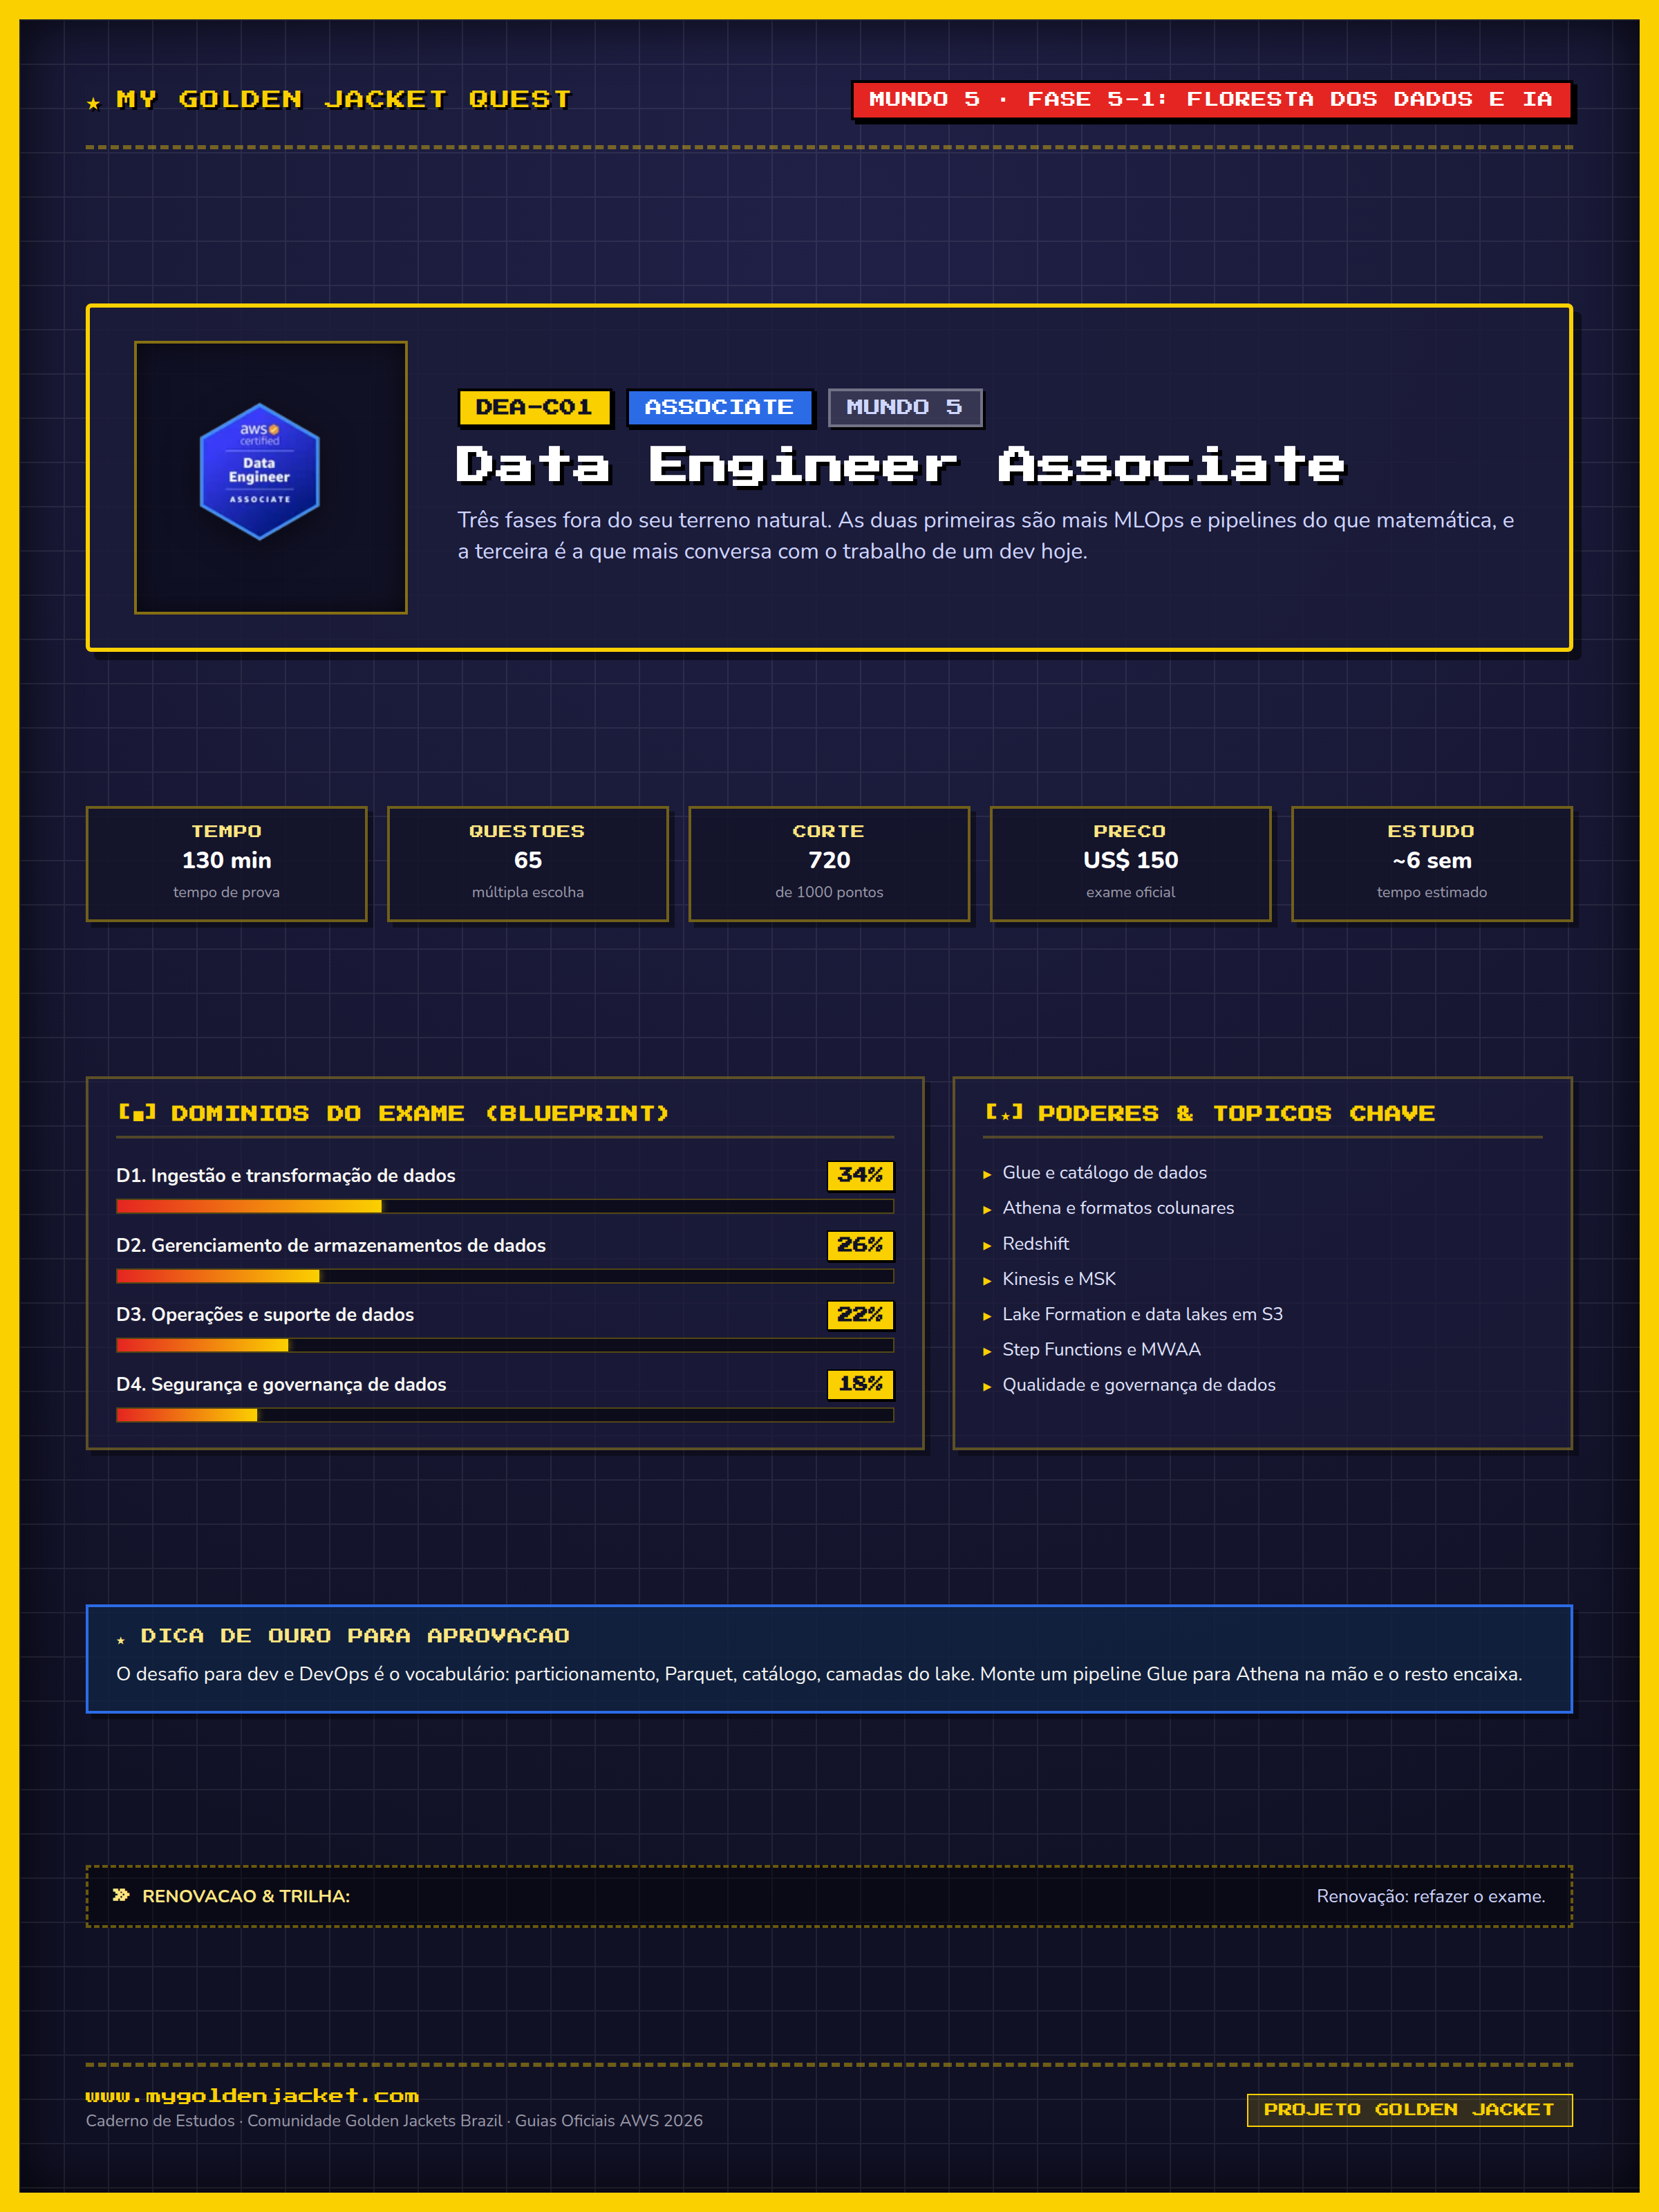
DOMÍNIOS
- 1 Ingestão e transformação de dados 34%
- 2 Gerenciamento de armazenamentos de dados 26%
- 3 Operações e suporte de dados 22%
- 4 Segurança e governança de dados 18%
Como estudar para o Data Engineer Associate (DEA-C01)
O Data Engineer Associate tem 65 questões em 130 minutos, nota mínima 720. Ingestão e transformação de dados pesa 34%: Glue (jobs, crawlers e catálogo), Kinesis e MSK para streaming, Lambda, Step Functions ou MWAA para orquestrar. Gerenciamento de armazenamentos (26%) compara S3, Redshift, DynamoDB e Lake Formation, com formatos colunares como Parquet e particionamento; operações (22%) e segurança e governança (18%) fecham com monitoramento, qualidade de dados, criptografia e controle de acesso por coluna.
Abre o Mundo 5, a Floresta dos Dados e IA. O pré-requisito prático é o Solutions Architect Associate (SAA-C03), pelos serviços de armazenamento e rede; o desafio para dev e DevOps é o vocabulário de dados, não a nuvem. É renovada pelo Generative AI Developer Professional (AIP-C01); sem ele, é refeita a cada três anos.
Seis semanas. Monte um pipeline de verdade: arquivos no S3, crawler do Glue, job que grava Parquet particionado e consulta no Athena; depois carregue o mesmo dado no Redshift e compare. O guia oficial deste exame só existe em inglês, e os tópicos foram traduzidos por nós seguindo a terminologia dos guias em português. Nas anotações, registre quando usar cada opção de ingestão (Kinesis Data Streams, Firehose, MSK, DMS): a prova vive dessa escolha.
Domínio 1: Ingestão e transformação de dados 34% do exame
1.1 Realizar a ingestão de dados.
Conhecimentos
- Características de throughput e latência dos serviços da AWS que fazem ingestão de dados
- Padrões de ingestão de dados (por exemplo, frequência e histórico de dados)
- Ingestão de dados em streaming
- Ingestão de dados em lote (por exemplo, ingestão agendada, ingestão orientada a eventos)
- Capacidade de reprocessamento (replay) de pipelines de ingestão de dados
- Transações de dados stateful e stateless
Habilidades
- Ler dados de fontes de streaming (por exemplo, Amazon Kinesis, Amazon Managed Streaming for Apache Kafka [Amazon MSK], Amazon DynamoDB Streams, AWS Database Migration Service [AWS DMS], AWS Glue, Amazon Redshift)
- Ler dados de fontes em lote (por exemplo, Amazon S3, AWS Glue, Amazon EMR, AWS DMS, Amazon Redshift, AWS Lambda, Amazon AppFlow)
- Implementar as opções de configuração adequadas para ingestão em lote
- Consumir APIs de dados
- Configurar agendadores usando o Amazon EventBridge, o Apache Airflow ou agendamentos baseados em tempo para trabalhos e crawlers
- Configurar gatilhos de eventos (por exemplo, notificações de eventos do Amazon S3, EventBridge)
- Chamar uma função do Lambda a partir do Amazon Kinesis
- Criar listas de permissões de endereços IP para permitir conexões com fontes de dados
- Implementar limitação (throttling) e contornar limites de taxa (por exemplo, DynamoDB, Amazon RDS, Kinesis)
- Gerenciar fan-in e fan-out na distribuição de dados em streaming
1.2 Transformar e processar dados.
Conhecimentos
- Criação de pipelines de ETL com base nos requisitos de negócios
- Volume, velocidade e variedade dos dados (por exemplo, dados estruturados, dados não estruturados)
- Computação em nuvem e computação distribuída
- Como usar o Apache Spark para processar dados
- Locais intermediários de preparação (staging) de dados
Habilidades
- Otimizar o uso de contêineres conforme as necessidades de performance (por exemplo, Amazon Elastic Kubernetes Service [Amazon EKS], Amazon Elastic Container Service [Amazon ECS])
- Conectar-se a diferentes fontes de dados (por exemplo, Java Database Connectivity [JDBC], Open Database Connectivity [ODBC])
- Integrar dados de várias fontes
- Otimizar custos durante o processamento de dados
- Implementar serviços de transformação de dados com base nos requisitos (por exemplo, Amazon EMR, AWS Glue, Lambda, Amazon Redshift)
- Transformar dados entre formatos (por exemplo, de .csv para Apache Parquet)
- Solucionar problemas e depurar falhas comuns de transformação e problemas de performance
- Criar APIs de dados para disponibilizar dados a outros sistemas usando serviços da AWS
1.3 Orquestrar pipelines de dados.
Conhecimentos
- Como integrar vários serviços da AWS para criar pipelines de ETL
- Arquitetura orientada a eventos
- Como configurar serviços da AWS para pipelines de dados com base em agendamentos ou dependências
- Fluxos de trabalho sem servidor
Habilidades
- Usar serviços de orquestração para criar fluxos de trabalho de pipelines de ETL de dados (por exemplo, Lambda, EventBridge, Amazon Managed Workflows for Apache Airflow [Amazon MWAA], AWS Step Functions, fluxos de trabalho do AWS Glue)
- Criar pipelines de dados visando performance, disponibilidade, escalabilidade, resiliência e tolerância a falhas
- Implementar e manter fluxos de trabalho sem servidor
- Usar serviços de notificação para enviar alertas (por exemplo, Amazon Simple Notification Service [Amazon SNS], Amazon Simple Queue Service [Amazon SQS])
1.4 Aplicar conceitos de programação.
Conhecimentos
- Integração contínua e entrega contínua (CI/CD) (implementação, teste e implantação de pipelines de dados)
- Consultas SQL (para consultas a fontes de dados e transformações de dados)
- Infraestrutura como código (IaC) para implantações repetíveis (por exemplo, AWS Cloud Development Kit [AWS CDK], AWS CloudFormation)
- Computação distribuída
- Estruturas de dados e algoritmos (por exemplo, estruturas de dados em grafo e em árvore)
- Otimização de consultas SQL
Habilidades
- Otimizar código para reduzir o tempo de execução da ingestão e da transformação de dados
- Configurar funções do Lambda para atender às necessidades de simultaneidade e performance
- Executar consultas SQL para transformar dados (por exemplo, procedimentos armazenados do Amazon Redshift)
- Estruturar consultas SQL para atender aos requisitos do pipeline de dados
- Usar comandos do Git para executar ações como criar, atualizar, clonar e ramificar repositórios
- Usar o AWS Serverless Application Model (AWS SAM) para empacotar e implantar pipelines de dados sem servidor (por exemplo, funções do Lambda, Step Functions, tabelas do DynamoDB)
- Usar e montar volumes de armazenamento de dentro de funções do Lambda
Domínio 2: Gerenciamento de armazenamentos de dados 26% do exame
2.1 Escolher um armazenamento de dados.
Conhecimentos
- Plataformas de armazenamento e suas características
- Serviços e configurações de armazenamento para demandas específicas de performance
- Formatos de armazenamento de dados (por exemplo, .csv, .txt, Parquet)
- Como alinhar o armazenamento de dados aos requisitos de migração de dados
- Como determinar a solução de armazenamento adequada para padrões de acesso específicos
- Como gerenciar bloqueios para impedir o acesso a dados (por exemplo, Amazon Redshift, Amazon RDS)
Habilidades
- Implementar os serviços de armazenamento adequados para requisitos específicos de custo e performance (por exemplo, Amazon Redshift, Amazon EMR, AWS Lake Formation, Amazon RDS, DynamoDB, Amazon Kinesis Data Streams, Amazon MSK)
- Configurar os serviços de armazenamento adequados para padrões de acesso e requisitos específicos (por exemplo, Amazon Redshift, Amazon EMR, Lake Formation, Amazon RDS, DynamoDB)
- Aplicar serviços de armazenamento aos casos de uso adequados (por exemplo, Amazon S3)
- Integrar ferramentas de migração a sistemas de processamento de dados (por exemplo, AWS Transfer Family)
- Implementar métodos de migração de dados ou de acesso remoto (por exemplo, consultas federadas do Amazon Redshift, visualizações materializadas do Amazon Redshift, Amazon Redshift Spectrum)
2.2 Entender sistemas de catalogação de dados.
Conhecimentos
- Como criar um catálogo de dados
- Classificação de dados com base em requisitos
- Componentes de metadados e catálogos de dados
Habilidades
- Usar catálogos de dados para consumir dados a partir da fonte
- Criar e referenciar um catálogo de dados (por exemplo, AWS Glue Data Catalog, metastore do Apache Hive)
- Descobrir esquemas e usar crawlers do AWS Glue para preencher catálogos de dados
- Sincronizar partições com um catálogo de dados
- Criar novas conexões de origem ou destino para catalogação (por exemplo, AWS Glue)
2.3 Gerenciar o ciclo de vida dos dados.
Conhecimentos
- Soluções de armazenamento adequadas para requisitos de dados quentes e frios
- Como otimizar o custo de armazenamento com base no ciclo de vida dos dados
- Como excluir dados para atender a requisitos de negócios e legais
- Políticas de retenção de dados e estratégias de arquivamento
- Como proteger dados com resiliência e disponibilidade adequadas
Habilidades
- Executar operações de carga (load) e descarga (unload) para mover dados entre o Amazon S3 e o Amazon Redshift
- Gerenciar políticas do S3 Lifecycle para mudar a classe de armazenamento dos dados no S3
- Expirar dados quando atingirem uma idade específica usando políticas do S3 Lifecycle
- Gerenciar o versionamento do S3 e o TTL do DynamoDB
2.4 Projetar modelos de dados e a evolução de esquemas.
Conhecimentos
- Conceitos de modelagem de dados
- Como garantir a exatidão e a confiabilidade dos dados usando linhagem de dados
- Práticas recomendadas de indexação, estratégias de particionamento, compressão e outras técnicas de otimização de dados
- Como modelar dados estruturados, semiestruturados e não estruturados
- Técnicas de evolução de esquemas
Habilidades
- Projetar esquemas para o Amazon Redshift, o DynamoDB e o Lake Formation
- Lidar com mudanças nas características dos dados
- Realizar conversão de esquemas (por exemplo, usando a AWS Schema Conversion Tool [AWS SCT] e o AWS DMS Schema Conversion)
- Estabelecer linhagem de dados usando ferramentas da AWS (por exemplo, Amazon SageMaker ML Lineage Tracking)
Domínio 3: Operações e suporte de dados 22% do exame
3.1 Automatizar o processamento de dados usando serviços da AWS.
Conhecimentos
- Como manter e solucionar problemas do processamento de dados para obter resultados de negócios repetíveis
- Chamadas de API para processamento de dados
- Quais serviços aceitam scripts (por exemplo, Amazon EMR, Amazon Redshift, AWS Glue)
Habilidades
- Orquestrar pipelines de dados (por exemplo, Amazon MWAA, Step Functions)
- Solucionar problemas de fluxos de trabalho gerenciados da Amazon
- Chamar SDKs para acessar recursos da Amazon a partir do código
- Usar os recursos dos serviços da AWS para processar dados (por exemplo, Amazon EMR, Amazon Redshift, AWS Glue)
- Consumir e manter APIs de dados
- Preparar a transformação de dados (por exemplo, AWS Glue DataBrew)
- Consultar dados (por exemplo, Amazon Athena)
- Usar o Lambda para automatizar o processamento de dados
- Gerenciar eventos e agendadores (por exemplo, EventBridge)
3.2 Analisar dados usando serviços da AWS.
Conhecimentos
- Compensações entre serviços provisionados e serviços sem servidor
- Consultas SQL (por exemplo, instruções SELECT com vários qualificadores ou cláusulas JOIN)
- Como visualizar dados para análise
- Quando e como aplicar técnicas de limpeza
- Agregação de dados, média móvel, agrupamento e pivotamento
Habilidades
- Visualizar dados usando serviços e ferramentas da AWS (por exemplo, AWS Glue DataBrew, Amazon QuickSight)
- Verificar e limpar dados (por exemplo, Lambda, Athena, QuickSight, Jupyter Notebooks, Amazon SageMaker Data Wrangler)
- Usar o Athena para consultar dados ou criar visualizações (views)
- Usar notebooks do Athena com Apache Spark para explorar dados
3.3 Manter e monitorar pipelines de dados.
Conhecimentos
- Como registrar dados de aplicações em log
- Práticas recomendadas de ajuste de performance
- Como registrar em log o acesso a serviços da AWS
- Amazon Macie, AWS CloudTrail e Amazon CloudWatch
Habilidades
- Extrair logs para auditorias
- Implantar soluções de registro em log e monitoramento para facilitar auditoria e rastreabilidade
- Usar notificações durante o monitoramento para enviar alertas
- Solucionar problemas de performance
- Usar o CloudTrail para rastrear chamadas de API
- Solucionar problemas e manter pipelines (por exemplo, AWS Glue, Amazon EMR)
- Usar o Amazon CloudWatch Logs para registrar dados de aplicações (com foco em configuração e automação)
- Analisar logs com serviços da AWS (por exemplo, Athena, Amazon EMR, Amazon OpenSearch Service, CloudWatch Logs Insights, logs de aplicações de big data)
3.4 Garantir a qualidade dos dados.
Conhecimentos
- Técnicas de amostragem de dados
- Como implementar mecanismos para lidar com distorção (skew) de dados
- Validação de dados (completude, consistência, exatidão e integridade dos dados)
- Criação de perfil (profiling) de dados
Habilidades
- Executar verificações de qualidade de dados durante o processamento (por exemplo, verificar campos vazios)
- Definir regras de qualidade de dados (por exemplo, AWS Glue DataBrew)
- Investigar a consistência dos dados (por exemplo, AWS Glue DataBrew)
Domínio 4: Segurança e governança de dados 18% do exame
4.1 Aplicar mecanismos de autenticação.
Conhecimentos
- Conceitos de segurança de rede em VPC
- Diferenças entre serviços gerenciados e não gerenciados
- Métodos de autenticação (baseados em senha, em certificado e em perfil)
- Diferenças entre políticas gerenciadas pela AWS e políticas gerenciadas pelo cliente
Habilidades
- Atualizar grupos de segurança de VPC
- Criar e atualizar grupos, perfis, endpoints e serviços do IAM
- Criar e alternar credenciais para gerenciamento de senhas (por exemplo, AWS Secrets Manager)
- Configurar perfis do IAM para acesso (por exemplo, Lambda, Amazon API Gateway, AWS CLI, CloudFormation)
- Aplicar políticas do IAM a perfis, endpoints e serviços (por exemplo, S3 Access Points, AWS PrivateLink)
4.2 Aplicar mecanismos de autorização.
Conhecimentos
- Métodos de autorização (baseados em perfil, em política, em tag e em atributo)
- Princípio do privilégio mínimo aplicado à segurança na AWS
- Controle de acesso baseado em perfil e padrões de acesso esperados
- Métodos para proteger dados contra acesso não autorizado entre serviços
Habilidades
- Criar políticas personalizadas do IAM quando uma política gerenciada não atende às necessidades
- Armazenar credenciais de aplicações e bancos de dados (por exemplo, Secrets Manager, AWS Systems Manager Parameter Store)
- Conceder acesso e autoridade a usuários, grupos e perfis em um banco de dados (por exemplo, no Amazon Redshift)
- Gerenciar permissões por meio do Lake Formation (para Amazon Redshift, Amazon EMR, Athena e Amazon S3)
4.3 Garantir a criptografia e o mascaramento de dados.
Conhecimentos
- Opções de criptografia de dados disponíveis nos serviços de análise da AWS (por exemplo, Amazon Redshift, Amazon EMR, AWS Glue)
- Diferenças entre criptografia no lado do cliente e no lado do servidor
- Proteção de dados sigilosos
- Anonimização, mascaramento e salting de chaves de dados
Habilidades
- Aplicar mascaramento e anonimização de dados de acordo com leis de conformidade ou políticas da empresa
- Usar chaves de criptografia para criptografar ou descriptografar dados (por exemplo, AWS Key Management Service [AWS KMS])
- Configurar criptografia entre limites de contas da AWS
- Habilitar a criptografia em trânsito para os dados.
4.4 Preparar logs para auditoria.
Conhecimentos
- Como registrar dados de aplicações em log
- Como registrar em log o acesso a serviços da AWS
- Logs centralizados da AWS
Habilidades
- Usar o CloudTrail para rastrear chamadas de API
- Usar o CloudWatch Logs para armazenar logs de aplicações
- Usar o AWS CloudTrail Lake para consultas centralizadas de logs
- Analisar logs usando serviços da AWS (por exemplo, Athena, CloudWatch Logs Insights, Amazon OpenSearch Service)
- Integrar vários serviços da AWS para realizar o registro em log (por exemplo, Amazon EMR em casos de grandes volumes de dados de log)
4.5 Entender privacidade e governança de dados.
Conhecimentos
- Como proteger informações de identificação pessoal (PII)
- Soberania de dados
Habilidades
- Conceder permissões para compartilhamento de dados (por exemplo, compartilhamento de dados no Amazon Redshift)
- Implementar a identificação de PII (por exemplo, Macie com Lake Formation)
- Implementar estratégias de privacidade de dados para impedir backups ou replicações de dados para Regiões da AWS não permitidas
- Gerenciar mudanças de configuração ocorridas em uma conta (por exemplo, AWS Config)
A AWS publicou este guia só em inglês; os tópicos foram traduzidos por nós seguindo a terminologia dos guias oficiais em português. Entre ou crie uma conta para registrar o que já domina, escrever anotações e anexar materiais.